問答集生成
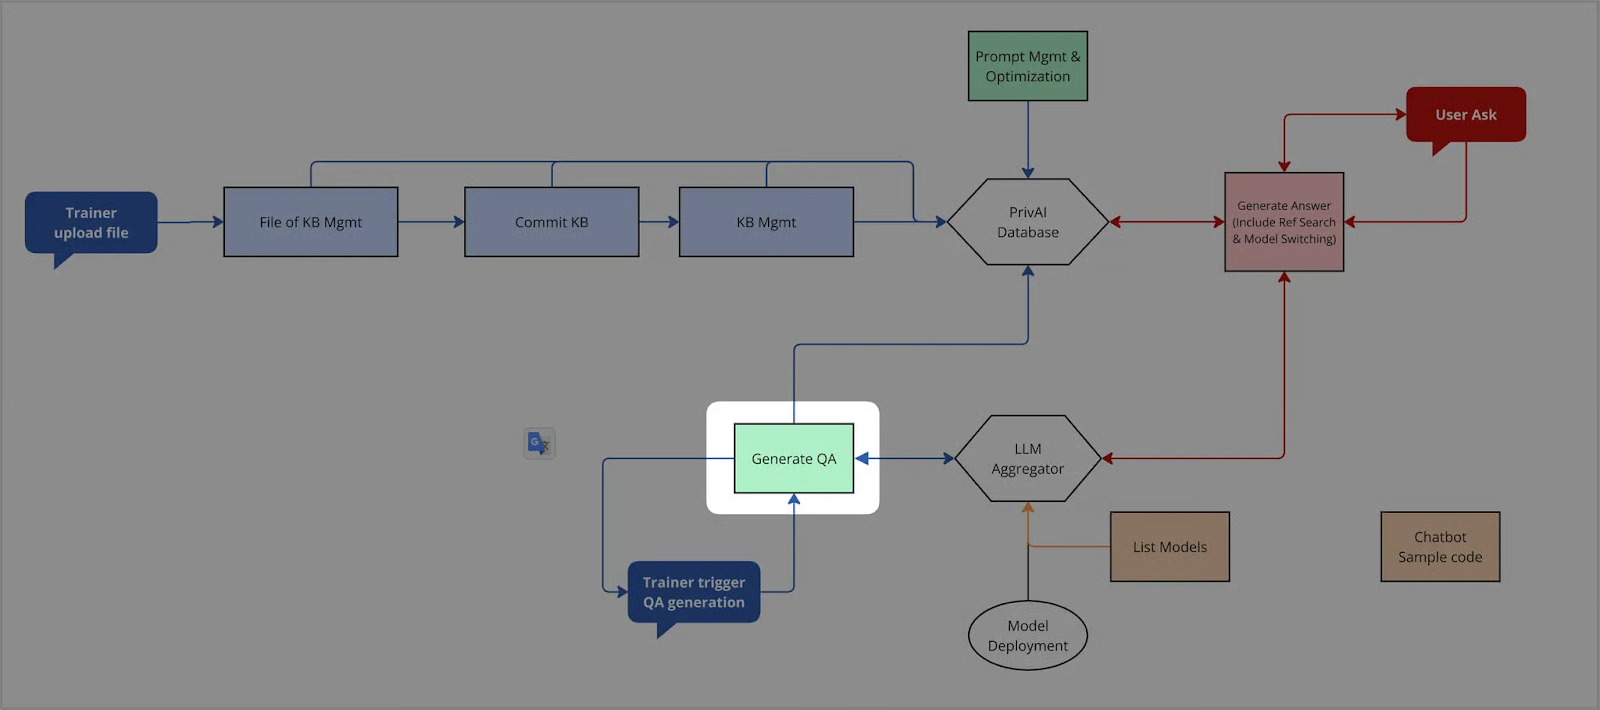
此 API 用於根據指定的 Fileset,自動生成問答集(QA Pairs),並輸出為標準格式的 QA 檔案,供後續人工校對、prompt 測試,或加入 Fileset 作為知識來源使用。
系統會依序處理 Fileset 中的每個檔案:
-
取得檔案的解析內容(尚未解析的檔案會先以
HQ模式解析,因此 Fileset 不需要先 commit) -
由 LLM 從內容中擷取可能的問題點(如定義、規則、流程),生成問題與參考答案
-
將所有檔案的結果彙整為一份
.xlsxQA 檔案,儲存為一筆 File 並回傳該檔案資訊
Fileset 中原本就是 QA 題庫檔(application/x-privai-qa)的檔案會被略過。此 API 為同步處理,會等所有檔案生成完畢才回應,檔案較多或較大時需要較長時間。
curl -X 'POST' \
  'http://127.0.0.1:8000/v1/qa/generate?fileset_id={fileset_id}' \
  -H 'accept: application/json' \
  -H "Authorization: Bearer $PRIVAI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "temperature": 0.7,
    "target_amount": 1,
    "on_oversize": "fail"
  }'
Request Headers
| Key | Value |
|---|---|
| Request Method | POST |
| accept | application/json |
| Authorization | Bearer $PRIVAI_API_KEY |
| Content-Type | application/json |
Query Parameters
| Field | Type | Note | Required |
|---|---|---|---|
| fileset_id | string | uuid,來源 Fileset | true |
Request Payload
{
  "model_name": "ace-1-24b-reasoning-v1",
  "extract_model_name": "ace-1-24b-reasoning-v1",
  "temperature": 0.7,
  "target_amount": 1,
  "on_oversize": "fail"
}
Field Explanation
| Field | Type | Detail | Required |
|---|---|---|---|
| model_name | string | 用來產生問答集的 LLM 模型,省略時使用系統預設模型。可用模型可由「取得所有模型」API 查詢 | false |
| extract_model_name | string | 用來將生成結果整理為結構化問答的模型,僅支援非 thinking 模型;省略時使用系統預設模型 | false |
| temperature | float | 控制生成文字的隨機性,範圍 0.0–1.0 | false |
| target_amount | integer | 可用值 1、2、3。每次呼叫模型時要求「至少」產生的 QA 數量;內容足夠時模型可能產生更多 | false |
| on_oversize | string | 單一檔案內容過長時的處理方式,可用值 fail、split。詳見下方說明 | false |
on_oversize 說明
單一檔案的解析文字過長時:
-
fail:回傳QA_003(400),整個請求中止,其他檔案即使已處理成功也不會產生 QA 檔案。 -
split:將內容切成多段(段落間有重疊)分別生成後合併,target_amount會套用到每一段。
Response Body
Status Code:201 Created(所有檔案皆成功時)
{
  "object": "file",
  "id": "792b40a2-8128-4a08-b5fc-517f040108fc",
  "filename": "QA_b9f375f8-048f-4d5a-a3ec-63b7f062f074.xlsx",
  "filetype": "application/x-privai-qa",
  "bytes": 4925,
  "metadata": {
    "source_fileset_id": "b9f375f8-048f-4d5a-a3ec-63b7f062f074"
  },
  "purpose": "user_data",
  "created_at": "2025-01-01T01:20:00.000Z",
  "expires_at": null,
  "failed_file_ids": [],
  "error_message": null
}
Field Explanation
| Field | Type | Description |
|---|---|---|
| object | string | 固定為 file |
| id | string (uuid) | 產生的 QA 檔案 ID |
| filename | string | 檔名,格式 QA_{fileset_id}.xlsx |
| filetype | string | 固定為 application/x-privai-qa |
| bytes | integer | 檔案大小(bytes) |
| metadata | object | 含 source_fileset_id(來源 Fileset ID) |
| purpose | string | (與 OpenAI 相容而保留),固定為 user_data |
| created_at | timestamp | 建立時間 |
| expires_at | timestamp | null | (與 OpenAI 相容而保留) |
| failed_file_ids | array | null | 生成失敗的來源檔案 ID 列表 |
| error_message | string | null | 有檔案失敗時的說明文字,無失敗時為 null |
部分檔案失敗時,HTTP 狀態碼為 400,但 Response Body 仍是上方的成功格式。此時 QA 檔案已成功建立(id 可用),只是不含失敗檔案的內容;failed_file_ids 列出失敗的來源檔案,error_message 為 Some files failed to generate QA pairs. Please refer to the API documentation.。請以 failed_file_ids/error_message 判斷是否有部分失敗,不要只依狀態碼判斷整體成敗,以免遺漏已產生的 QA 檔案。
QA 檔案格式
產生的 QA 檔案是一般的 File,可透過「下載檔案」API(file_type=raw_file)下載為 .xlsx,也可以加入 Fileset 後 Commit,作為知識來源使用。檔案第一列為標題 question、answer,每列一組問答:
| question | answer |
|---|---|
| Customer's name? | Mr Bean |
| Booking Number | B32VO3 |
問答內容以來源文件的主要語言生成;系統可能會將中文內容轉換為台灣繁體用字。
常見錯誤代碼
| Error Code | HTTP Status | 情境 |
|---|---|---|
| FILESET_001 | 404 | 指定的 Fileset 不存在 |
| FILESET_005 | 400 | Fileset 內沒有任何檔案 |
| QA_001 | 400 | 所有檔案皆未能產生 QA pairs(內容為空、全部失敗,或 Fileset 內只有 QA 題庫檔) |
| QA_003 | 400 | on_oversize=fail 且有檔案內容過長,整批處理中止 |
| — | 422 | temperature 超出 0.0–1.0、target_amount 不是 1–3 的整數,或 on_oversize 不是 fail/split |
QA_002 不會以錯誤格式(error_code)回傳,僅出現在部分失敗時的 error_message 說明中(見上方提醒)。身份驗證錯誤(AUTH_001~AUTH_003)請參考「錯誤代碼說明-身份驗證類」章節;問答集生成相關錯誤碼完整說明請參考 錯誤代碼說明-問答集生成類。